AI 做的網站漏資料、Project Zero 縮短揭露期、PyPI 加上來源證明
01Lovable 做的網站,有些不用登入就讀得到別人的資料深入篇
掃了 15.9 萬個 Lovable 專案,7,400 個網站用網頁裡本來就有的 key,就查得到含 email 的資料。
- 案例:德國論壇 8 萬多個會員檔案、20 萬則以上聊天訊息;一家服務業者有護照號碼。
- 約佔「一打開就送資料」那 2.4 萬個網站的三成——但作者說這不是外洩率,有些 email 本來就公開。
- 研究:德國資安公司 Crissy Field 與德國商報 Handelsblatt。
展開完整說明
Lovable 是用 AI 生成網頁應用的平台,不寫程式也能做出網站。研究者從公開的網頁封存資料找出 159,000 多個專案,其中 34,000 多個用 Supabase 當資料庫,24,000 多個網站一打開就從 Supabase 送出資料,不需要登入。這本身不一定有問題,有些資料本來就該公開。但用網頁裡同一把 key 多查幾次,在 7,400 個網站、10,000 多張資料表裡找到含 email 的紀錄。細節見下方深入篇。
02Project Zero 改規則:回報滿 90 天就公開,之後縮到 30 天
Google 的漏洞研究團隊取消「修好後再等 30 天」,而且公開期限會一路縮短。
| 時間 | 規則 |
|---|---|
| 2021 年起 | 90 天修,修好後再給 30 天(90+30) |
| 現在 | 回報滿 90 天就公開,不管修好沒有 |
| 2027 年 2 月 | 60 天 |
| 2028 年 1 月 | 30 天 |
- 理由是 AI:有些目標以前一年找到幾個漏洞,現在一週好幾個;攻擊者也能從修補檔很快反推出漏洞。
- HN 上有人擔心修得太快,沒時間好好審 AI 寫的修補。
03Google Antigravity 的 /teamwork:一群 agent 分工,還有專門挑錯的角色
兩個設計:很多 agent 平行嘗試、由外部工具判對錯;挑錯的角色在乾淨的 context 裡驗收。
- 讓機器閱卷:用證明檢查器、原封不動的測試套件、模擬器判對錯,不問模型「你覺得對嗎」。
- 乾淨 context:每個 agent 只拿這一步需要的檔案;審查者看不到原作者思路,只驗成品。
- 成果:AV1 解碼器改寫成約 17 萬行 Rust,輸出逐位元相同、比 C++ 快兩到三成;Borg 排程讓某些硬體上 TPU 工作被搶占少了 24%。
- 注意:這是成果彙整,評測細節在各自論文,且都有人類專家參與。
04PyPI 套件頁多了 Security 分頁:裝之前先看來源證明
每個檔案都能看有沒有「來源證明」(attestation)——像食品的產地和批號標籤。
- 兩種證明:透過 Trusted Publisher(GitHub、GitLab 等 CI)發布;或連回確切的 commit 和建置環境。
- 頁首有四種警示,最該注意兩種:來源 repo 或流程跟上一版不同(可能搬家,也可能被盜)、以前有證明這版突然沒了。
- 沒有證明不代表有問題,很多老專案本來就沒設;本機建置的人目前拿不到證明。
05同一個問題換成別的語言問 AI,耗電可以差上百倍
Qwen3 8B 測 122 種語言:英文最省,普什圖語總耗電是英文的 179 倍;中文約 2 倍。
- 原因相乘:不熟的語言被切成更多 token、回答更長;回答越長,GPU 能同時處理的請求越少,每個 token 更耗電。
- 限制:模型較舊、沒測閉源模型;HN 上有人用新模型重跑,中文結果差異很大。
06NVIDIA:兩台 DGX Station 合跑一個 GLM 大模型
7,500 億參數的 GLM-5.3 放不進一顆 GPU,就把每一層切兩半、兩台各算一半(tensor parallelism)。
- 模型約 460 多 GB,單顆 GPU 記憶體 250 多 GB;兩台用 400 Gb/s RDMA 直連。
- 標題的「每秒 607 token」是 16 個請求加總;單人約每秒 100 多個,32 個請求時總量反而掉到 385。
07Cloudflare 推出花費上限:超過就直接暫停
Spend Management(beta):到上限就自動暫停產品,從「響警報」變成「跳電閘」。
- 目前只支援 Workers 和 Durable Objects。
- 計價不在請求路徑上(1 分鐘、5 分鐘彙整後計價,再把封鎖推到各節點),不拖慢請求;代價是約 10 分鐘延遲。
08終端機的邊框,可以不再佔掉一整格
Ratatui 維護者提出協定草案:邊框變成格子的屬性,畫在格子邊緣,不佔字元。
- 16 吋筆電約 50 列,巢狀面板常有 6 到 8 列只用來畫線;新做法複製貼上也不會帶出框線。
- 先查詢終端機支不支援,不支援就退回傳統畫法;目前只在作者自己的 Ghostty 分支、macOS 上跑過。
09ggml 1.0:llama.cpp 底下的那個函式庫
清掉已棄用的舊 API、加 FP8,CUDA、Metal、Vulkan 後端都有優化。
- release notes 沒說 1.0 代表 API 從此穩定。
10華爾街日報報導:Nvidia 融資給新創,讓它們買自家 GPU二手資訊
據報導,Nvidia 投資或擔保 AI 新創,新創再拿錢買 Nvidia 的 GPU,讓需求看起來一直很旺。
- 來源鏈:TechPowerUp ← Wccftech ← 華爾街日報(付費牆,我們沒讀到原文);依據是匿名知情人士。
- HN 上有人貼出原文段落,說比較像需求下滑、合約退不掉的壓力,沒有標題「製造稀缺」那麼戲劇化。
11一張軟體職稱的家族樹:從 1940 年代到 AI 時代
104 個職稱,從「Computer」(當時指人)到 AI Agent、Context Engineer。
- 職稱會拆了又合:webmaster → 前端/後端 → full-stack;名字也會被回收。年份是作者的「最佳猜測」。
12LinkedIn、Monster 下架一千多則假職缺:其實是直銷招募
1,500 多則「在家工作、免經驗」旅遊規劃職缺,都通往同一家要先付費的美國直銷公司。
- CBC 報導後,LinkedIn 下架近 900 則、Monster 600 則;CBC 交白紙履歷也收到說明會邀請。
13與其買樹莓派,不如用一支舊手機?
樹莓派加相機、GPS、行動網路要 300 多美元;幾十美元的二手手機全都內建。
- HN 的提醒:沒有長期維護的核心、長期插電電池可能膨脹、要湊幾百支同款二手機很難。
14拆開一顆 1965 年系列的 DTL 邏輯晶片
Ken Shirriff 開蓋一顆 Signetics 600 系列晶片:四個 NAND 閘,用二極體電晶體邏輯。
- 多出兩顆用不到的二極體:同一片矽做三種晶片,只換最上層金屬接線。
Lovable 做的網站,資料怎麼漏出去的
三句話講完:
1. 研究者用網頁裡本來就公開的 key 多查幾次,在 7,400 個 Lovable 網站讀到含 email 的資料,有的含護照號碼。
2. 關鍵不是 key 外洩,而是資料表上的存取規則(RLS)沒開;用程式建表時,RLS 預設不開。
3. 「三成」不是外洩率;但任何前端直連資料庫的應用,都該用沒登入的身分實際查一次。
背景:平台說不用懂技術,責任卻在使用者
Lovable 是瑞典新創做的平台:用聊天描述想要什麼,它就生出一整個網頁應用,賣點是不需要技術背景。但它的使用條款把應用和資料處理的責任放在使用者身上。德國漢堡的資安公司 Crissy Field 說這是一個令人不安的落差。
他們想回答:已上線的 Lovable 網站,有多少會把不該公開的資料交給任何一個路過的人?
先搞懂 Supabase:鑰匙公開,靠每個房間上鎖
Supabase 讓網頁前端直接查資料庫。前端帶的那把 key 本來就是公開的;真正擋人的,是資料表上的規則 row-level security(RLS),決定每一列資料誰能讀。
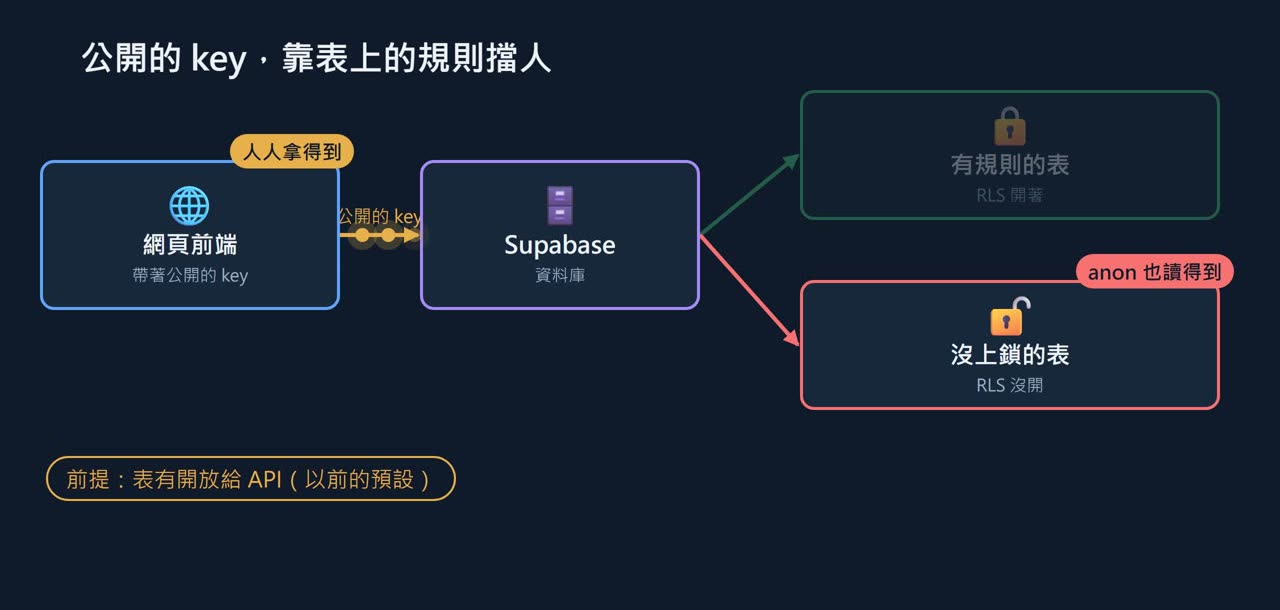
沒登入的訪客在 Supabase 裡也是一個角色,叫 anon。一張忘了開 RLS、又開放給 API 的表,對全世界都是打開的——而以前的預設就是開放。
他們怎麼做:三步縮小範圍
| 步驟 | 做什麼 | 數量 |
|---|---|---|
| 1. 找網站 | 從 Common Crawl 網頁封存找 2025/12–2026/09 的 Lovable 專案 | 159,000+ |
| 其中用 Supabase 當資料庫 | 34,500+ | |
| 2. 觀察 | 一打開就從 Supabase 送出資料、不用登入(本身不一定是漏洞) | 24,600+ |
| 3. 延伸 | 用同一把 key 發唯讀查詢,找到含 email 的紀錄 | 7,400+ |
讀到了什麼
- 德國生活風格論壇:80,000 多個會員檔案(姓名、email、生日),以及 200,000 則以上聊天訊息。
- 活動主辦和餐廳:好幾萬筆紀錄,含電話、地址、付款資訊。
- 一家服務業者:1,000 多筆身分文件資料,含護照號碼、到期日和國籍。
為什麼一找就是一大批?文章說 Lovable 的資料庫整合有固定套路,一個網站有效的查法,幾乎不用改就能套到別的網站。
根因是 RLS 設得不夠——這是 Hacker News 上一位自稱 Lovable 資安主管的說法(文章本身沒用 RLS 這個詞)。Lovable 官方部落格 11/10 也寫,最常見的問題就是資料存取規則開得太寬,但那篇沒提到這份研究。
不只是 Lovable:用程式建表,預設就不鎖
資安公司 UpGuard 10 月的研究,從約 300,000 個用到 Supabase 的網域出發,不分是誰做的,找到 16,000 多個資料庫有可讀的資料表,超過一半看起來含個人資料。他們指出一個預設值差異:
| 建表方式 | RLS 預設 |
|---|---|
| 在 Supabase 介面上手動建表 | 開 |
| 透過 API 用程式建表(coding agent 的方式) | 不開 |
限制與爭議
- 三成不是外洩率。有些 email 是公開聯絡信箱或測試資料;沒有 email 的個資這個方法抓不到。樣本來自網頁封存,不代表全部;也無法確認資料有沒有被人拿去用。
- 研究倫理。有人認為證明讀得到就夠,不該多抓;自稱作者的人回覆每張表只抓第一頁,用來判斷是否敏感,完整結果已交給 Lovable。另一派認為不看紀錄分不出公開資料還是個資。
- 責任歸屬。平台?還是 Supabase 為了好上手把預設設太寬?Supabase 今年已改成新建的表不再自動開放給資料 API(10 月底套用到所有專案),但已存在的表維持原樣,不能說問題已解決。
- 利益揭露。Crissy Field 是賣應用安全服務的公司。
你的團隊可以怎麼檢查
文章的建議:處理真實客戶資料前,檢查存取權限,以及不同使用者之間的資料有沒有隔開,每次大改後再查一次;自動掃描不能取代專業的安全評估。以下是我們的檢查清單:
- 列出每張表「誰能讀、誰能寫」——Supabase、Firebase 或自己做的前端直連設計都適用。
- 用沒登入的身分實際查一次,不要只看設定畫面。
- 讓 AI agent 建表、改 schema 時,把存取規則寫成必要步驟,code review 專門看這一項。
- 拿掉登入直接打 API:還拿得到資料嗎?
- 用一個普通帳號登入,試著讀別人的資料:讀得到嗎?只要有一題答案是「可以」,登入畫面就只是裝飾。
大門的鑰匙本來就是公開的,安全全看每個房間有沒有上鎖。下次讓 AI 幫你建資料表,記得問它一句:這張表,誰能讀?